En este artículo
- Las cuatro formas de usar DeepSeek
- Opción 1: usar la API
- VRAM: la variable que determina el coste
- Precios de GPUs cloud
- Proveedores europeos
- Marketplaces GPU low-cost
- Horas reales de utilización
- Servidores dedicados
- Matriz económica por modelo
- El coste real: TCO completo
- Escenarios de arquitectura
- Model Routing: el error más caro
- Cómo reducir el coste
- API vs GPU privada
- El sweet spot
- Preguntas frecuentes
DeepSeek ha cambiado la economía de desplegar inteligencia artificial. Ya no es necesario asumir que operar un modelo avanzado requiere una infraestructura de decenas o cientos de miles de euros.
Pero decir que «DeepSeek es barato» simplifica demasiado el problema. El coste puede ir desde decenas de euros al mes utilizando una API hasta más de 20.000 EUR mensuales para una infraestructura privada multi-GPU.
La pregunta correcta no es «¿cuánto cuesta DeepSeek?», sino: ¿cuánto cuesta ejecutar el modelo adecuado para mi carga, privacidad, concurrencia y nivel de servicio?
Las cuatro formas de usar DeepSeek
| Modalidad | Inversión | Privacidad | Escalabilidad | Complejidad |
|---|---|---|---|---|
| API | Muy baja | Media CHINA | Muy alta | Muy baja |
| GPU cloud bajo demanda | Baja | Alta | Alta | Media |
| GPU cloud 24×7 | Media | Alta | Alta | Media |
| Servidor dedicado | Media | Muy alta RGPD | Media | Alta |
| Cluster privado | Alta | Muy alta RGPD | Muy alta | Muy alta |
No existe una opción universalmente mejor. Para una aplicación pequeña, la API suele ganar económicamente. Para una empresa que procesa información sensible de forma continua, la inferencia privada puede ser mucho más interesante.
Opción 1: usar la API de DeepSeek
La alternativa más sencilla: no desplegar ningún modelo. Tu aplicación consume DeepSeek mediante API y paga únicamente por los tokens procesados.
Esto elimina prácticamente toda la infraestructura asociada: GPUs, CUDA, drivers, servidores, almacenamiento de pesos, motores de inferencia, escalado, balanceo y monitorización de GPU.
Para aplicaciones con tráfico pequeño o irregular, la API puede resultar extraordinariamente difícil de superar económicamente.
Conclusión económica
Si utilizas pocas decenas o incluso centenares de millones de tokens mensuales, calcula cuidadosamente el punto de equilibrio antes de alquilar una GPU permanente. La ecuación cambia cuando aparecen requisitos de privacidad, soberanía, latencia o utilización sostenida.
VRAM: la variable que determina el coste
La memoria de la GPU es el factor que más influye en qué modelos puedes ejecutar y, por tanto, en cuánto vas a pagar.
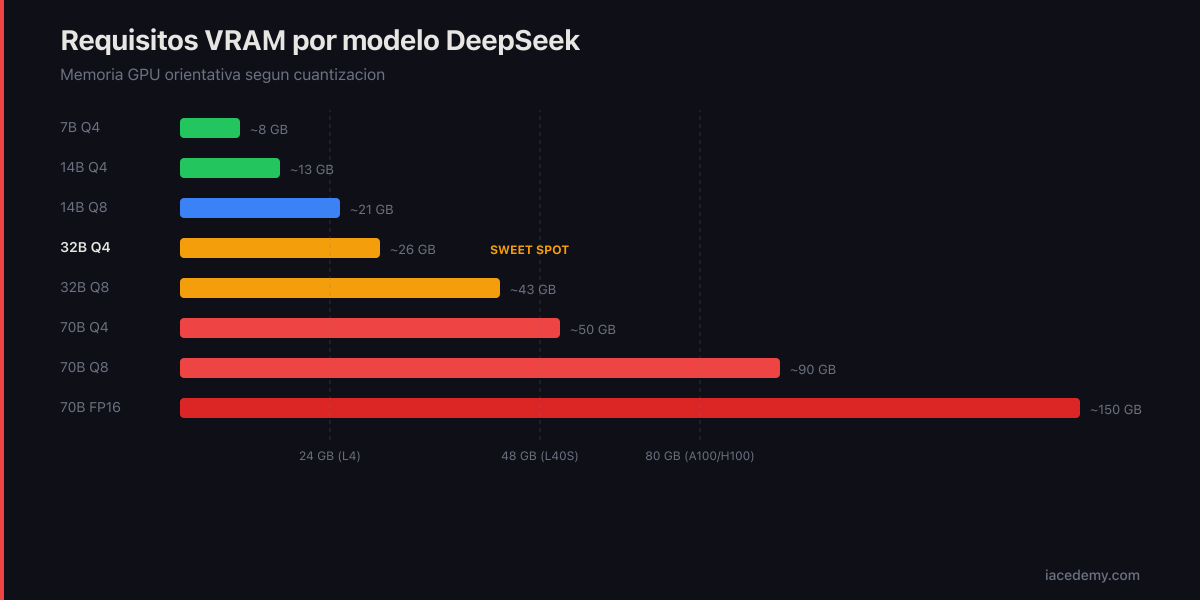
| Modelo | Cuantización | VRAM orientativa | GPU objetivo |
|---|---|---|---|
| 7-8B | Q4 | ~6-10 GB | A4000 / L4 / RTX |
| 7-8B | FP16 | ~16-20 GB | L4 / RTX |
| 14B | Q4 | ~10-16 GB | L4 / RTX |
| 14B | Q8 | ~18-24 GB | L4 / RTX |
| 32B | Q4 SWEET SPOT | ~22-30 GB | A6000 / L40S |
| 32B | Q8 | ~38-48 GB | A6000 / L40S |
| 32B | FP16 | ~70 GB | A100 / H100 |
| 70B | Q4 | ~45-55 GB | A100 / H100 |
| 70B | Q8 | ~80-100 GB | H200 / multi-GPU |
| 70B | FP16 | ~150 GB | 2× H100 |
| Frontier/MoE | variable | cientos de GB | cluster |
Estas cifras son orientativas. La memoria real depende de longitud del contexto, KV caché, concurrencia, batch size, motor de inferencia y tensor parallelism. Una GPU capaz de cargar un modelo no significa necesariamente que pueda servirlo eficientemente a muchos usuarios.
Precios de GPUs cloud
Los precios varían considerablemente entre proveedores. Los marketplaces pueden resultar mucho más económicos que los hyperscalers, mientras que los proveedores europeos ofrecen ventajas en soberanía y contratación.
Hyperstack (referencia global)
| GPU | VRAM | Precio/h | 8 h/día | 24×7/mes |
|---|---|---|---|---|
| A4000 | 16 GB | $0,15 | $36 | $110 |
| A6000 48 GB | 48 GB | $0,50 | $120 | $365 |
| L40 | 48 GB | $1,00 | $240 | $730 |
| A100 | 80 GB | $1,35 | $324 | $986 |
| H100 | 80 GB | $2,50 | $600 | $1.825 |
| H100 SXM | 80 GB | $3,20 | $768 | $2.336 |
| H200 | 141 GB | $3,99 | $958 | $2.913 |
| RTX Pro 6000 | 96 GB | $1,85 | $444 | $1.351 |
El dato especialmente interesante: GPUs de 48 GB a precios muy inferiores a una H100. Para muchos modelos cuantizados, esa categoría puede representar el verdadero sweet spot económico.
El módulo de IA aplicada cubre desde Ollama local hasta vLLM en la nube.
Proveedores europeos: OVHcloud y Scaleway
Cuando aparecen requisitos de soberanía, RGPD o localización del procesamiento en la UE, los proveedores europeos son la opción natural.
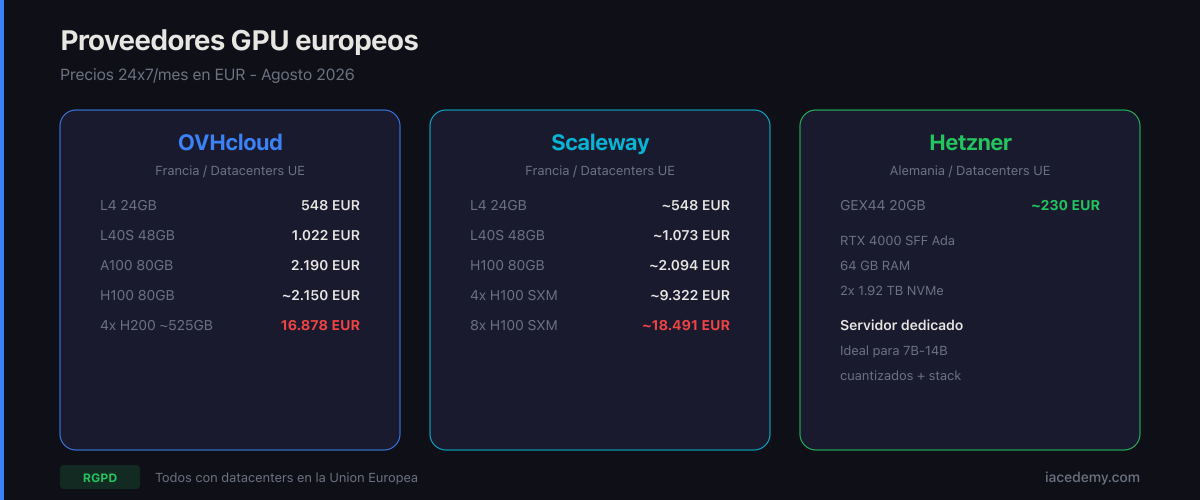
OVHcloud
| GPU | VRAM | EUR/h | 8 h/día | 24×7/mes |
|---|---|---|---|---|
| L4 | 24 GB | €0,75 | €180 | €548 |
| A10 | 24 GB | €0,76-0,90 | €182-216 | €555-657 |
| L40S | 48 GB | €1,40 | €336 | €1.022 |
| A100 | 80 GB | ~€3,00 | €720 | €2.190 |
| H100 | 80 GB | €2,80-3,10 | €672-744 | €2.044-2.263 |
| 4× H200 | ~525 GB | ~€23,12 | €5.549 | €16.878 |
Para modelos pequeños y medianos, L4 y L40S son posiblemente más interesantes que H100. Una H100 no debería ser la GPU por defecto solo porque sea más potente.
Scaleway
| Configuración | VRAM | EUR/h | 24×7/mes |
|---|---|---|---|
| L4 | 24 GB | ~€0,75 | ~€548 |
| L40S | 48 GB | ~€1,47 | ~€1.073 |
| H100 | 80 GB | ~€2,87 | ~€2.094 |
| 2× H100 SXM | 160 GB | ~€6,62 | ~€4.833 |
| 4× H100 SXM | 320 GB | ~€12,77 | ~€9.322 |
| 8× H100 SXM | 640 GB | ~€25,33 | ~€18.491 |
Las configuraciones multi-GPU empiezan a tener sentido cuando necesitas alta concurrencia, modelos grandes o una plataforma corporativa de inferencia.
Marketplaces GPU: Vast.ai y el mercado low-cost
Los marketplaces GPU cambian considerablemente la ecuación. Vast.ai permite alquilar capacidad ofrecida por diferentes proveedores, por lo que los precios fluctusan continuamente.
| GPU | Precio low-cost aprox. | 24×7/mes |
|---|---|---|
| RTX 4090 | ~$0,65/h | ~$475 |
| L40S | ~$0,64/h | ~$467 |
| A100 | ~$0,70/h | ~$511 |
| H100 | ~$1,87/h | ~$1.365 |
| H200 | ~$2,82/h | ~$2.059 |
La variable olvidada: horas reales de utilización
Una GPU no tiene por qué permanecer encendida todo el mes. Supongamos una GPU de 48 GB a $0,50/h:
| Utilización | Horas/mes | Compute |
|---|---|---|
| 1 hora/día | 30 | $15 |
| 2 horas/día | 60 | $30 |
| 4 horas/día | 120 | $60 |
| 8 horas/día | 240 | $120 |
| 12 horas/día | 360 | $180 |
| 24×7 | 730 | $365 |
Esta tabla explica por qué el autoscaling y scale-to-zero pueden resultar más importantes económicamente que conseguir una GPU ligeramente más barata. Un modelo 32B privado podría costar decenas de dólares mensuales si solo se activa cuando existe trabajo.
Servidores dedicados: una alternativa sorprendentemente competitiva
Cuando una GPU permanece ocupada muchas horas al día, los servidores dedicados empiezan a ser extremadamente interesantes.
Hetzner ofrece servidores GPU dedicados. Una configuración GEX44 puede incluir:
- NVIDIA RTX 4000 SFF Ada (20 GB VRAM)
- 64 GB RAM
- 2×1,92 TB NVMe
- Conectividad dedicada
Coste aproximado: ~230 EUR/mes.
Para modelos 7B/8B y 14B cuantizados, esto cambia radicalmente la economía. Además del LLM puedes ejecutar en la misma infraestructura: embeddings, reranking, PostgreSQL, Redis, Qdrant, APIs, workers y agentes. Los 230 EUR no representan exclusivamente el coste del LLM.
Descarga la guía maestra de Claude (gratis)
Prompts avanzados, workflows y atajos que no encontrarás en la documentación oficial. PDF directo a tu email.
Matriz económica por tamaño de modelo
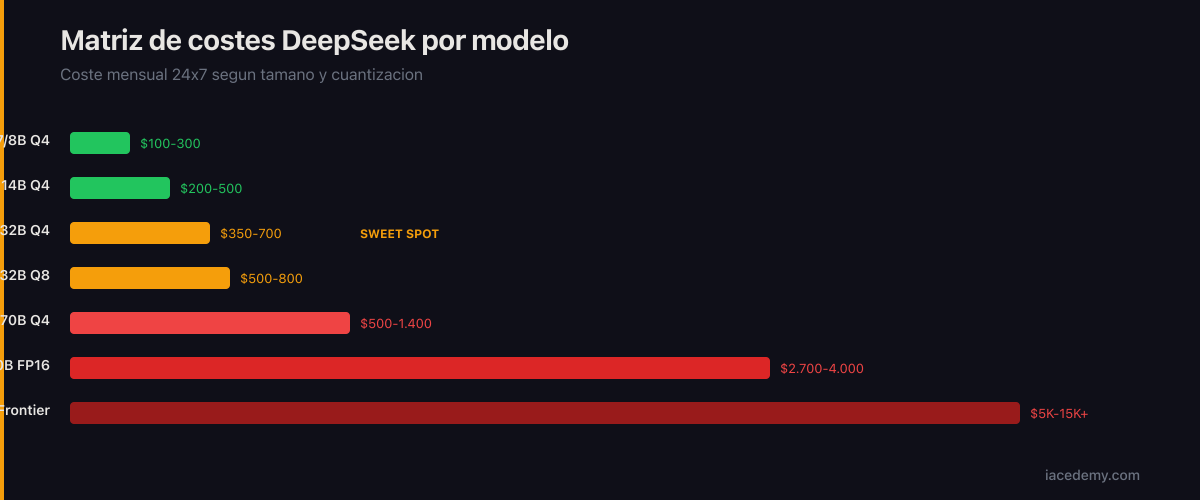
| Modelo | Infraestructura | Low-cost 24×7 | Cloud Enterprise EU |
|---|---|---|---|
| 7/8B Q4 | A4000/L4 | $100-300 | ~€500 |
| 14B Q4 | L4/RTX | $200-500 | ~€550 |
| 32B Q4 SWEET SPOT | A6000/L40S | $350-700 | ~€1.000 |
| 32B Q8 | A6000/L40S | $500-800 | ~€1.000 |
| 70B Q4 | A100/H100 | $500-1.400 | ~€2.000 |
| 70B FP16 | 2× H100 | $2.700-4.000 | €4.000-5.000 |
| Frontier | H100/H200 cluster | $5K-15K+ | €10K-20K+ |
32B cuantizado representa uno de los puntos más interesantes de toda la curva precio/capacidad. Proporciona un nivel de razonamiento considerable sin entrar en la economía de clusters H100/H200.
El coste real no es solo la GPU
Un error frecuente: calcular Precio GPU × 730 horas = coste de IA. El TCO es mayor.
| Componente | Pequeño | Medio | Enterprise |
|---|---|---|---|
| GPU | €50-500 | €500-2.000 | €2K-20K+ |
| CPU / control plane | €20-50 | €50-150 | €200-1K |
| Storage | €5-20 | €20-100 | €100-500 |
| Vector database | €10-30 | €30-150 | €200+ |
| Redis / caché | €5-20 | €20-100 | €100+ |
| Observabilidad | €10-30 | €30-200 | €500+ |
| Backups | €5-20 | €20-100 | €100+ |
| Seguridad | €10-50 | €50-300 | €500+ |
Y aún faltarían costes humanos: DevOps, MLOps, seguridad, actualizaciones, monitorización, optimización e incident response.
Escenarios de arquitectura
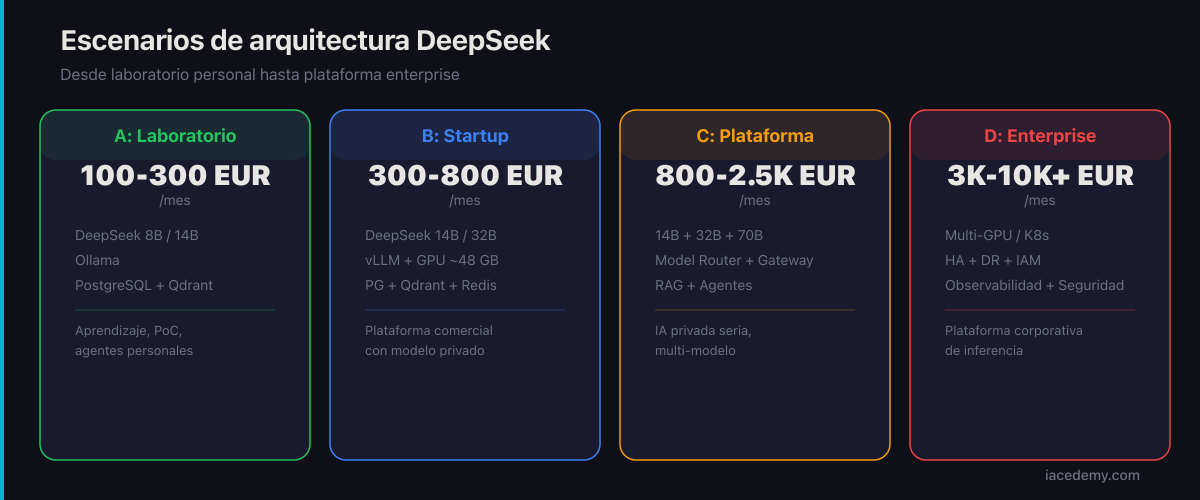
Escenario A: Laboratorio (100-300 EUR/mes)
DeepSeek 8B / 14B
       │
    Ollama
       │
API / Agents
       │
PostgreSQL + Qdrant
Adecuado para aprendizaje, desarrollo, PoC, automatizaciones internas y agentes personales.
Escenario B: Producto o startup (300-800 EUR/mes)
         API Gateway
              │
            vLLM
              │
     DeepSeek 14B / 32B
              │
  ┌──────────┼──────────┐
  │          │          │
PostgreSQL  Qdrant     Redis
GPU de ~48 GB. Puede ser suficiente para construir una plataforma comercial considerable.
Escenario C: Plataforma privada (800-2.500 EUR/mes)
            AI Gateway
                 │
            Model Router
                 │
  ┌────────────┼────────────┐
  │            │            │
 14B           32B          70B
 FAST        GENERAL     REASONING
  │            │            │
  └────────────┴────────────┘
                 │
           RAG / Agents
El modelo 70B puede permanecer apagado hasta que sea necesario. Aquí ya hablamos de infraestructura de IA privada seria.
Escenario D: Enterprise HA (3.000-10.000+ EUR/mes)
Múltiples GPUs, Kubernetes, alta disponibilidad, redundancia, observabilidad, DR, IAM, network segmentation e inference gateway. El problema deja de ser «ejecutar DeepSeek»: estamos construyendo una plataforma corporativa de inferencia.
El error de arquitectura más caro: usar el modelo grande para todo
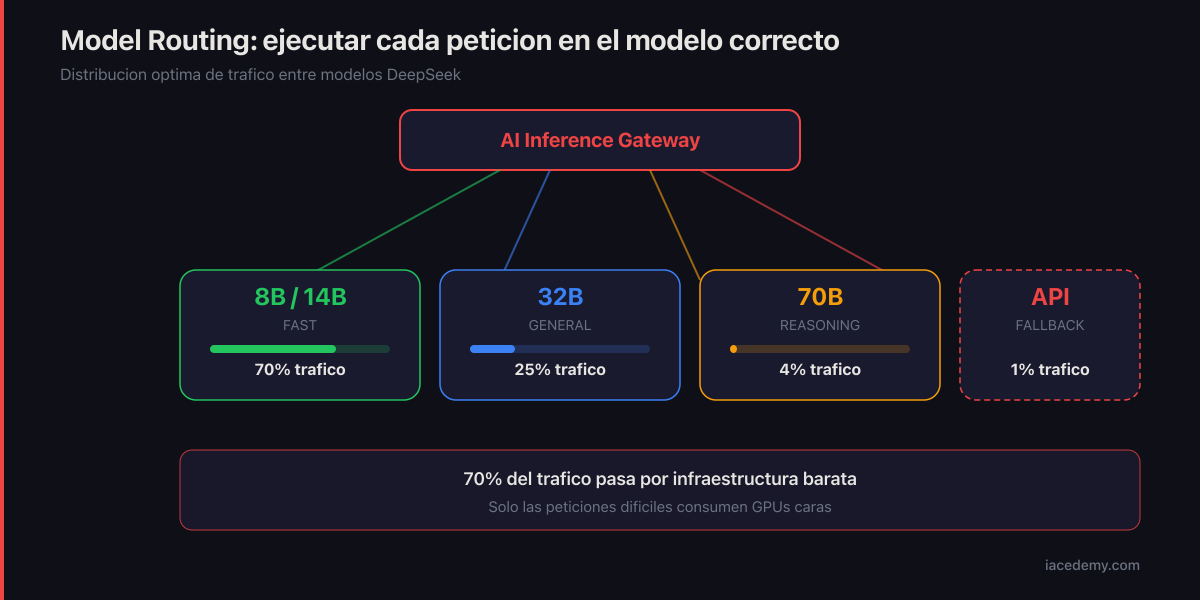
Supongamos cuatro clases de tareas: clasificación, extracción, análisis y razonamiento complejo. No tiene sentido procesarlas todas con un modelo 70B.
| Modelo | Tráfico | Uso |
|---|---|---|
| 8/14B | 70% | Clasificación, extracción, routing, herramientas |
| 32B | 25% | Análisis, programación, generación compleja |
| 70B | 4% | Razonamiento profundo, validación |
| API | 1% | Overflow, modelos frontier, redundancia |
La mayor parte del tráfico pasa por infraestructura barata. Solo las peticiones realmente difíciles consumen GPUs caras.
AI Inference Gateway
Un gateway puede decidir a qué modelo enviar cada petición basado en: sensibilidad del dato, complejidad, SLA, coste máximo, contexto, disponibilidad, latencia y tipo de agente. Esto convierte el coste en una variable controlable por software.
Cómo reducir todavía más el coste
Quantization. FP16 → FP8 → INT8 → INT4. Reduce memoria y puede aumentar throughput.
Continuous batching. Agrupa solicitudes y aumenta la utilización de GPU.
Prefix caching. Especialmente importante para agentes que reutilizan grandes system prompts.
KV caché. Evita recomputaciones innecesarias.
Semantic caché. Respuestas a preguntas similares previamente procesadas. La inferencia más barata es la que no necesitamos ejecutar.
Scale-to-zero. Apagar modelos caros cuando no hay peticiones. Mantener 8/14B y 32B siempre encendidos; 70B y frontier on-demand.
Motor de inferencia. vLLM y SGLang para producción. llama.cpp y Ollama para escenarios sencillos. La elección del runtime puede modificar significativamente los tokens por segundo y el coste efectivo por token.
API frente a GPU privada: cómo decidir
Elegir API cuando:
- El volumen es bajo o el tráfico impredecible
- Quieres comenzar rápidamente
- No existen requisitos estrictos de aislamiento
- No quieres operar infraestructura
Elegir GPU privada cuando:
- Existe carga sostenida (más de 4-8h/día)
- Los datos son sensibles o regulados
- Necesitas control sobre el modelo o personalizar
- Necesitas soberanía (RGPD, ENS)
- Utilizas múltiples agentes continuamente
Elegir arquitectura híbrida cuando:
- Quieres optimizar simultáneamente coste, privacidad y capacidad
Para muchas organizaciones, la arquitectura híbrida es probablemente la solución óptima.
El sweet spot: 500-1.000 EUR/mes
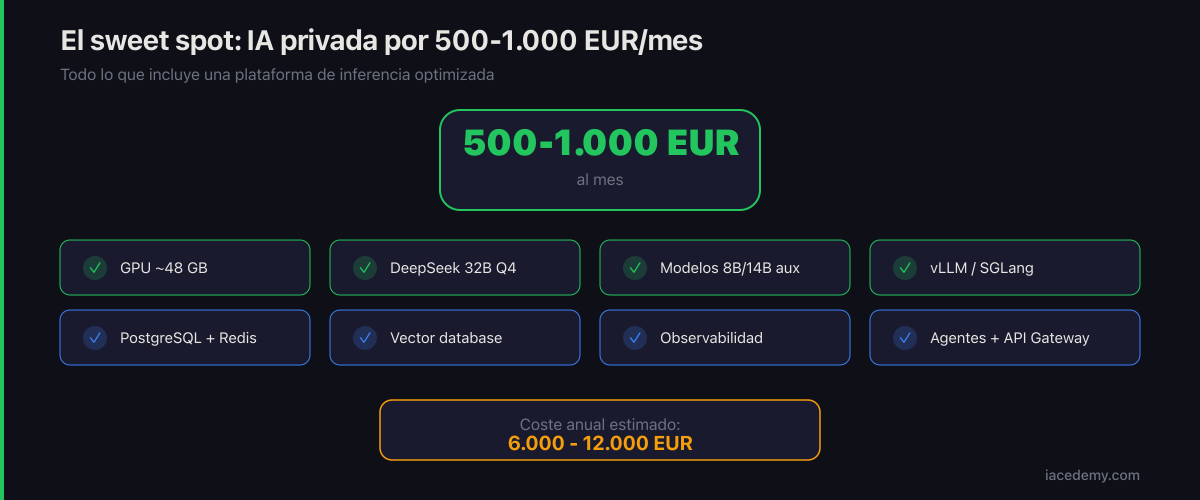
Para una organización que quiera construir seriamente alrededor de modelos privados, existe una zona especialmente interesante:
500-1.000 EUR mensuales.
Con una arquitectura optimizada puedes disponer de:
- GPU de ~48 GB
- DeepSeek 32B cuantizado
- Modelos 8B/14B auxiliares
- vLLM o SGLang
- PostgreSQL + Redis + vector database
- Almacenamiento + observabilidad
- Agentes + API Gateway
- Acceso ocasional a modelos superiores
Eso supone 6.000-12.000 EUR anuales. Una cifra muy diferente de la percepción tradicional de que la IA privada requiere inversiones de cientos de miles de euros.
Presupuesto rápido por arquitectura
API solamente: 10-200 EUR/mes
Laboratorio: 100-300 EUR/mes
DeepSeek privado pequeño: 200-500 EUR/mes
Plataforma 32B: 500-1.000 EUR/mes
32B + 70B on-demand: 800-2.000 EUR/mes
Enterprise: 3.000-10.000 EUR/mes
Frontier cluster: 10K-25K+ EUR/mes
El curso avanzado de IAcademy cubre vLLM, model routing, RAG y agentes en producción.
La siguiente frontera: comprar la GPU
Existe un punto a partir del cual el cloud deja de ser económico. Una GPU cloud a 1.000 EUR/mes son 36.000 EUR en tres años. Si un servidor equivalente puede adquirirse por una fracción (incluyendo electricidad, refrigeración y mantenimiento), la compra puede ser superior.
El cálculo que toda organización con carga estable debería hacer: cloud vs servidor dedicado vs GPU propia.
Conclusión
DeepSeek permite construir infraestructuras de IA con perfiles económicos radicalmente diferentes. Desde 20 EUR/mes con API hasta 25.000+ EUR/mes con clusters frontier.
La verdadera optimización consiste en ejecutar cada petición sobre el modelo más pequeño capaz de resolverla correctamente.
Una arquitectura basada en Model Routing + Quantization + Continuous Batching + Caching + Scale-to-Zero + API Fallback puede reducir radicalmente el coste frente a mantener un modelo enorme permanentemente cargado.
En determinados escenarios, una infraestructura DeepSeek privada completa puede costar menos que muchas licencias SaaS empresariales convencionales.
Preguntas frecuentes
¿Cuánto cuesta ejecutar DeepSeek en la nube?
Desde pocos euros al mes (API) hasta 10.000+ EUR/mes (clusters). El sweet spot para la mayoría de organizaciones está entre 500 y 1.000 EUR/mes: suficiente para una GPU de 48 GB con DeepSeek 32B cuantizado, modelos auxiliares, base de datos y observabilidad.
¿Qué GPU necesito para ejecutar DeepSeek?
Para 7-8B cuantizado: GPU con 10 GB VRAM (A4000, L4). Para 32B cuantizado: 24-48 GB (A6000, L40S). Para 70B: 80+ GB (A100, H100). El sweet spot económico está en GPUs de 48 GB.
¿Es más barato usar la API o una GPU propia?
Para volúmenes bajos o tráfico irregular, API. Con carga sostenida (más de 4-8h/día), GPU cloud o dedicada. Considera también la privacidad: la API de DeepSeek procesa datos en China.
¿Qué proveedores europeos hay?
OVHcloud (L4 a ~0,75 EUR/h, H100 a ~2,80 EUR/h), Scaleway (configuraciones hasta 8×H100 SXM), y Hetzner (servidores dedicados desde ~230 EUR/mes). Todos con datacenters en la UE para cumplimiento RGPD.
Descarga la guía maestra de Claude (gratis)
Prompts avanzados, workflows y atajos que no encontrarás en la documentación oficial. PDF directo a tu email.
Domina la IA aplicada: desde Ollama hasta clusters en producción
Los 3 primeros módulos de IAcademy son gratis. Incluyen prompting avanzado, LLMs locales y automatización con IA.
Empieza gratisCurso completo: 614 módulos de IA aplicada
23 especializaciones por departamento. Dashboard con progreso. Quizzes y skills desbloqueables. Desde 19 EUR.
📚 Aprende más en el curso
Este artículo complementa el Módulo M01: Como funciona la IA. Incluye vídeo, quiz, flashcards con repaso espaciado y proyecto práctico.